JEV: как революционная decision-модель меняет архитектуру AI-агентов
Большие языковые модели научились генерировать текст, но принятие решений остается отдельной задачей. В этой статье мы разбираем, как внедрение новой decision-модели JEV позволило решить одну из ключевых проблем RAG-систем — отличать найденный документ от действительно найденного ответа. На примере AI-консультанта «Связист» показываем, как меняется архитектура современных AI-агентов и почему специализированные модели становятся важным дополнением к LLM.
Pardus · Главный редактор
За последние два года архитектура большинства AI-систем стала практически стандартной: документы загружаются в RAG-библиотеку, поиск находит подходящие материалы, а большая языковая модель (LLM) формирует ответ пользователю. Такой подход работает во множестве проектов — от корпоративных баз знаний до технических консультантов.
Однако во время разработки AI-консультанта «Связист» мы столкнулись с проблемой, которая характерна практически для любой RAG-системы.
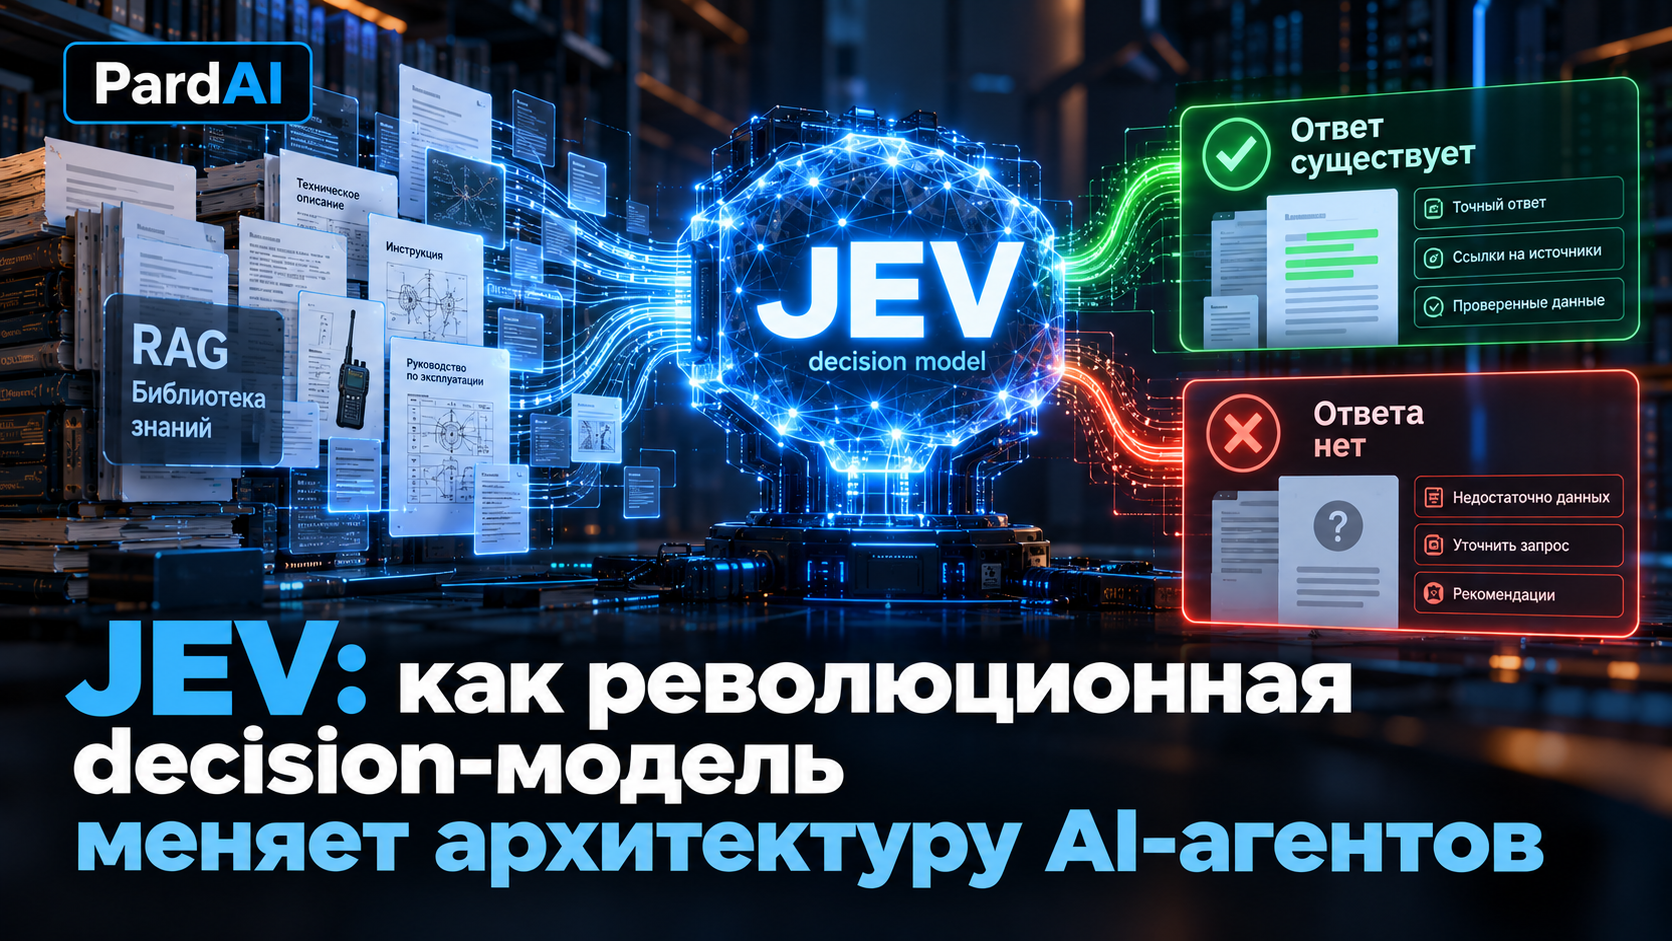
Найденный документ совсем не означает, что ответ действительно существует.
Именно решение этой задачи стало причиной внедрения новой decision-модели JEV. В этой статье мы расскажем, как она изменила архитектуру AI-консультанта и почему считаем подобные модели следующим этапом развития интеллектуальных агентов.
Главная проблема современных RAG-систем
Представим простой пример.
Пользователь спрашивает:
«Как настроить радиостанцию Р-168?»
RAG-библиотека действительно находит нужный документ.
Но внутри найденного фрагмента оказывается лишь содержание документа:
1. Назначение
2. Настройка
3. Эксплуатация
4. Технические характеристики
С точки зрения поиска задача выполнена — документ найден.
С точки зрения пользователя — ответа нет.
Большая языковая модель не виновата. Она честно использует предоставленный контекст и пытается построить ответ на основании найденного текста. Если информации недостаточно, никакая LLM не сможет «додумать» технические данные без риска галлюцинаций.
Именно здесь возникает фундаментальная проблема современных RAG-систем: необходимо понять не только то, что найден документ, но и то, содержит ли он достаточную информацию для формирования качественного ответа.
Почему эвристики перестают работать
Первая версия «Связиста» решала эту задачу при помощи набора эвристик.
Мы анализировали объем найденного текста, наличие определенных признаков, структуру документа, различные служебные параметры и десятки других условий.
На первых этапах этого оказалось достаточно.
Но по мере роста библиотеки знаний и увеличения количества документов число исключений постоянно росло.
Каждое новое правило исправляло одну ситуацию, но одновременно усложняло всю систему.
В какой-то момент стало очевидно: проблему невозможно решить бесконечным набором условий.
Нужен механизм, который сможет самостоятельно принимать решение.
Что такое JEV
Именно тогда мы обратили внимание на новую модель JEV.
В отличие от больших языковых моделей, JEV не предназначена для генерации текста.
Это специализированная decision-модель.
Ее задача — получать входные данные, анализировать их и принимать решение с оценкой собственной уверенности.
JEV не пишет статьи, не отвечает пользователю и не заменяет LLM.
Она отвечает на совершенно другой вопрос:
«Можно ли доверять найденному результату?»
Именно такая специализация делает модель чрезвычайно быстрой — около 300–400 миллисекунд на запрос — и очень дешевой по стоимости использования.
Новая архитектура «Связиста»
После публикации статьи о платформе PardAI многие спрашивали, как устроен сам AI-консультант.
Сегодня его архитектура выглядит следующим образом.
Вопрос пользователя
        │
        ▼
PardAI RAG
        │
Поиск документов
        │
        ▼
JEV принимает решение
        │
 ┌──────────────┐
 │Информации    │
 │достаточно    │
 └──────┬───────┘
        │
        ▼
LLM формирует ответ
        │
        ▼
Ответ пользователю

или

 ┌──────────────┐
 │Информации    │
 │недостаточно  │
 └──────┬───────┘
        │
        ▼
Сообщить пользователю,
что база знаний
не содержит ответа
Таким образом JEV становится своеобразным «арбитром» между поиском и языковой моделью.
Он определяет, имеет ли смысл вообще запускать генерацию ответа.
Проверка на реальных данных
Перед интеграцией мы провели серию офлайн-тестов.
Для проверки использовались реальные запросы AI-консультанта и реальные результаты поиска по базе знаний.
При классификации входящих запросов модель показала точность 92,2%.
Отдельно проверялись случаи, которые традиционно вызывают проблемы у RAG-систем: когда поиск возвращает оглавление, список разделов или краткое упоминание темы вместо полноценного описания.
Во всех восьми контрольных примерах JEV корректно определил, что найденного материала недостаточно для формирования качественного ответа.
Именно эта способность стала главным аргументом в пользу внедрения модели.
Что изменилось после внедрения
Главное изменение почти незаметно для пользователя.
Теперь AI-консультант перестал уверенно отвечать там, где база знаний фактически не содержит необходимой информации.
Если раньше поиск мог вернуть формально подходящий документ, после чего LLM пыталась построить ответ на недостаточном контексте, то теперь подобные ситуации выявляются еще до генерации текста.
В результате пользователь либо получает полноценный ответ, либо честное сообщение о том, что имеющихся данных недостаточно.
На наш взгляд, второй вариант значительно лучше красивого, но бесполезного текста.
Почему это важнее, чем кажется
На первый взгляд может показаться, что речь идет лишь об одной функции AI-консультанта.
На самом деле речь идет об изменении всей архитектуры интеллектуальных систем.
Сегодня большие языковые модели постепенно перестают быть единственным компонентом AI.
Рядом с ними появляются специализированные модели, каждая из которых решает свою задачу значительно лучше универсальных LLM.
RAG отвечает за поиск знаний.
LLM отвечает за генерацию текста.
Decision-модель отвечает за принятие решений.
Именно такое разделение ролей делает AI-системы более предсказуемыми, надежными и экономичными.
Что дальше
Сегодня JEV уже используется в AI-консультанте «Связист».
Но мы рассматриваем это лишь как первый этап.
В дальнейшем decision-модели могут стать одним из базовых компонентов платформы PardAI.
Они способны выбирать оптимального AI-агента, принимать решение о необходимости веб-поиска, оценивать качество результатов RAG, выполнять интеллектуальную маршрутизацию запросов и контролировать дорогостоящие операции перед обращением к большим языковым моделям.
По сути, речь идет о появлении нового класса специализированных AI-компонентов, которые работают рядом с LLM, а не вместо них.
Вывод
Наш опыт показал, что следующая эволюция AI связана не только с появлением более мощных языковых моделей.
Не менее важную роль начинают играть специализированные системы принятия решений.
Внедрение JEV позволило AI-консультанту «Связист» научиться отличать ситуацию, когда документ найден, от ситуации, когда ответ действительно существует.
Именно этот небольшой на первый взгляд шаг существенно повысил качество работы всей системы.
Мы уверены, что в ближайшие годы decision-модели станут таким же обязательным элементом архитектуры AI-агентов, каким сегодня уже являются RAG и большие языковые модели.
```