Языковая модель на борту дрона: как маленький ИИ помогает обходить людей
Исследователи запустили на Jetson языковую модель с 0,5 млрд параметров, которая назначает ограничения для обхода препятствий. Разбираем архитектуру, роль RAG и кэша, результаты в симуляции и главный вопрос: где действительно нужна модель, а где достаточно таблицы правил.
Pardus · Главный редактор
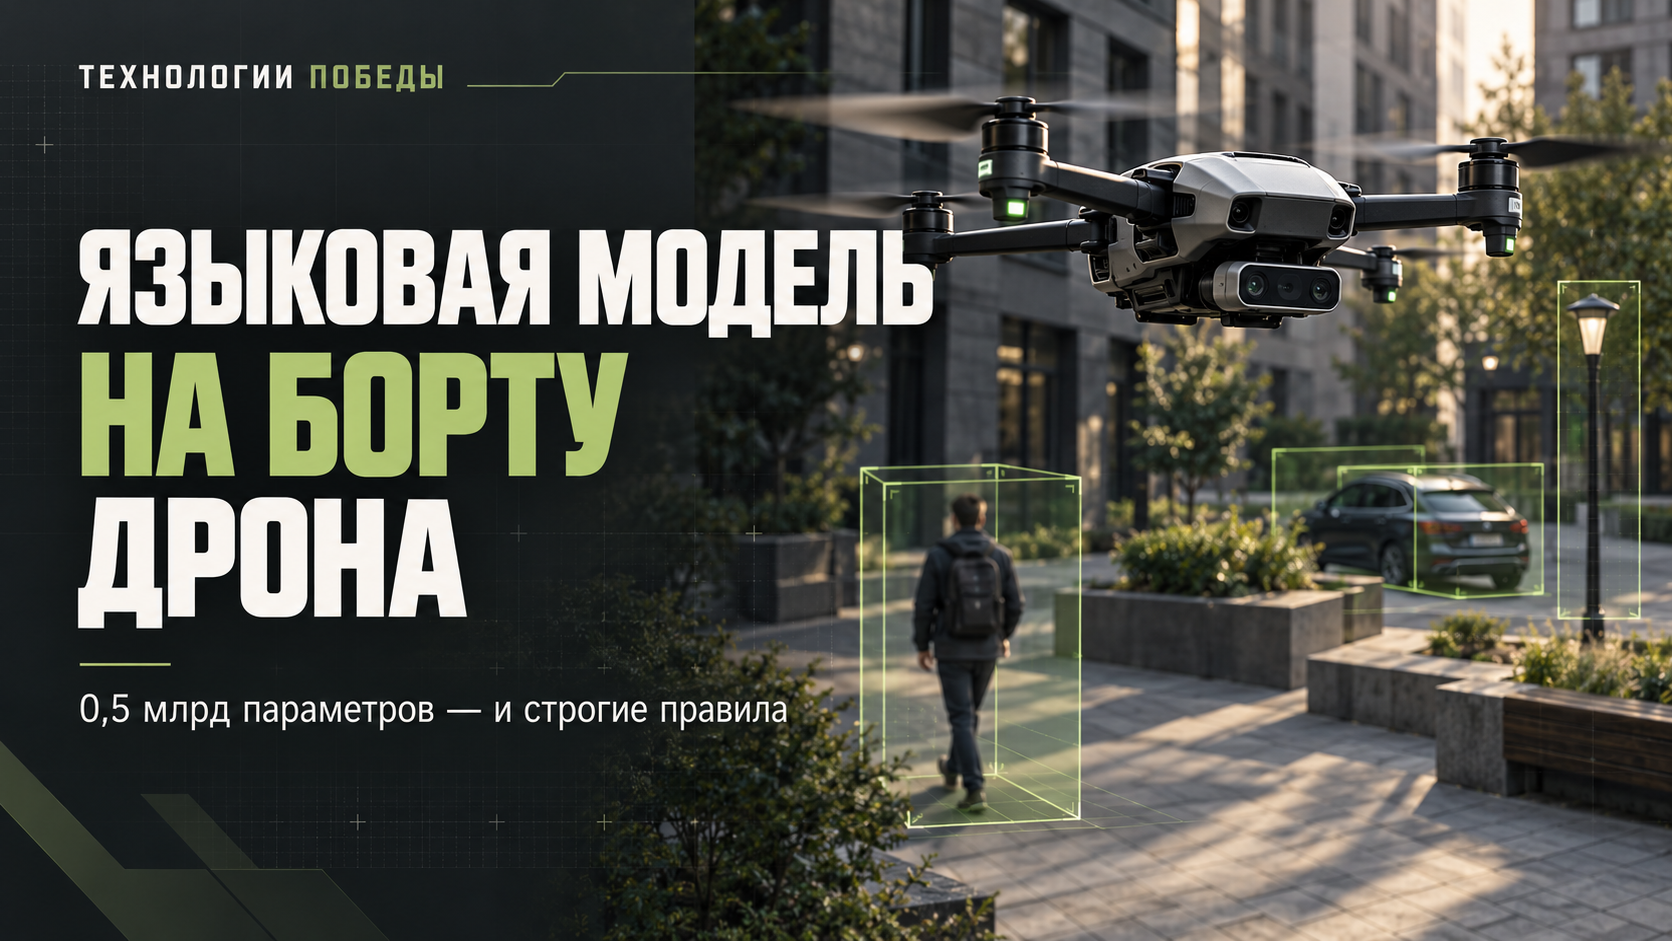
Для геометрического планировщика человек и фонарный столб во многом похожи: оба занимают пространство, через которое нельзя лететь. Но пилот понимает разницу. Столб останется на месте, а человек может шагнуть в сторону. Значит, одинакового обхода недостаточно: рядом с людьми нужны другие ограничения.
Исследователи из Drexel University и GRASP Lab Пенсильванского университета предложили добавить в эту цепочку языковую модель на 0,5 млрд параметров. Она определяет свойства класса препятствий и размер небезопасной области вокруг них. Траекторию по-прежнему рассчитывает обычный планировщик.
Работа интересна устройством системы: авторы ограничили полномочия модели, вынесли её задержки из критического контура и предусмотрели поведение на случай ошибочного ответа. При этом результаты требуют внимательного чтения: все полётные эксперименты выполнены в симуляции.
Почему облако здесь не подходит
Авторы рассматривают канал связи с исходящей скоростью около 100 кбит/с. Передача одного JPEG размером 384 × 384 пикселя занимает примерно восемь секунд. Затем нужно дождаться ответа модели: средние задержки составили 1,62 секунды для GPT-3.5-Turbo, 2,80 секунды для GPT-4o и 2,42 секунды для GPT-5.1-low. Пиковые значения превышали 4,7 секунды.
Полный цикл может занять около десяти секунд. На скорости 1 м/с это могло бы соответствовать десяти метрам пути. Важно: это оценка авторов, а не измеренный пролёт аппарата в ожидании облачного ответа.
В предложенной архитектуре восприятие, языковая модель и планирование работают на борту. Однако локальный запуск сам по себе не устраняет задержку. Поэтому модель вызывают только при необходимости, а управление продолжает работать независимо от неё.
Три блока с разными полномочиями
Восприятие. Общий замороженный энкодер BLIP ViT-B/16 примерно на 86 млн параметров обслуживает описание сцены и сегментацию по текстовому запросу. Данные глубины переводят маски объектов в трёхмерные координаты. В языковую модель поступает короткое текстовое описание — около 30 токенов.
Рассуждение. Qwen-2.5-0.5B-Instruct работает через llama.cpp с четырёхбитной квантизацией Q4_K_M. Результат ограничен двумя полями: считается ли объект динамическим и какой размер небезопасного бокса ему назначить. Модель не выдаёт путевые точки, скорости или команды двигателям.
Действие. Полученные небезопасные области поступают в планировщик. Для городского сценария авторы используют EGO-Planner, для посадки — kinodynamic A* совместно с MPC. Такое разделение позволяет менять планировщик, сохраняя интерфейс семантического модуля.
Это принципиальная граница ответственности. Языковая модель предлагает параметр ограничения. За построение и исполнение траектории отвечают специализированные алгоритмы.
Четыре приёма, которые стоит забрать в свою архитектуру
- Небольшая база правил вместо надежды на память модели. RAG объединяет плотный поиск через bge-small-en-v1.5 и BM25. Результаты сводятся через Reciprocal Rank Fusion, после чего в промпт попадают только top-k фрагментов. Модель получает подходящие правила безопасности перед формированием ответа.
- Ограничение формата на этапе генерации. GBNF-грамматика удерживает вывод в заданной JSON-структуре. При ошибке валидации система использует консервативный бокс по умолчанию. При этом корректный JSON ещё не гарантирует правильного значения внутри него.
- Кэширование по классу. Для уже известной категории ответ берётся из кэша. Повторно распознанный человек не требует нового рассуждения на каждом кадре. Запрос при промахе кэша занимает около 0,8 секунды и вынесен из критического контура управления.
- Сохранение препятствия при потере видимости. Объект получает идентификатор, а его последняя небезопасная область остаётся на карте ещё три секунды после исчезновения из кадра. Правило действует для всех объектов, а не только для людей.
Последний пункт заслуживает отдельного внимания. Человек, скрывшийся за автомобилем, продолжает существовать. Если карта слишком быстро освобождает занятую область, даже правильная семантическая оценка перестаёт помогать. Кратковременное удержание объекта закрывает этот разрыв, хотя не заменяет прогноз его движения.
Почему выбрали Jetson Orin NX
Авторы сравнили несколько платформ. Intel NUC 13 Pro весил 256 г без корпуса, потреблял более 40 Вт и не имел тензорных ядер. На Jetson Orin Nano с 8 ГБ памяти и режимом 15 Вт весь стек не поместился. Рабочим вариантом стал Jetson Orin NX с 16 ГБ: 25 Вт и около 180 г вместе с платой-носителем.
С Qwen-2.5-0.5B система занимала около 5,6 ГБ памяти, а ответ модели требовал 0,75–0,79 секунды. Llama-3.1-8B помещалась в память, но отвечала дольше 3,3 секунды. Для ряда других моделей и конфигураций сжатия авторы отмечают частые нарушения требуемой JSON-схемы.
Сравнение на Orin NX показывает цену обработки изображения внутри VLM: связка BLIP и Qwen-2.5-0.5B давала ответ за 0,79 секунды, Qwen2-VL-2B — за 2,77 секунды, PaliGemma-3B — за 4,75 секунды, SmolVLM — за 7,54 секунды, LLaVA-Phi-3 — за 7,62 секунды.
Здесь авторы сознательно сжимают визуальную информацию до текста. Около 30 текстовых токенов заменяют 144–576 визуальных токенов у сравниваемых VLM. Выигрыш сопровождается ограничением: языковая модель получает только то, что сохранил в описании модуль восприятия.
Что получилось в симуляции
В Gazebo исследователи проверяли посадку рядом с движущимися людьми. На каждую комбинацию метода и среды приходилось 50 испытаний. Полная система улучшила результат во всех трёх средах, но значение 96% относится только к открытому полю.
| Среда в симуляции Gazebo | Успешные посадки без LLM | Успешные посадки с полной системой |
|---|---|---|
| Открытое поле | 34% | 96% |
| Город | 28% | 74% |
| Лес | 32% | 80% |
Самый показательный результат — вариант с той же LLM без RAG. В симуляции он обеспечил только 6–12% успешных посадок, то есть оказался хуже исходного решения без языковой модели. Само подключение LLM пользы не гарантировало. Работоспособной оказалась система с дополнительными ограничениями и опорой на правила.
В городском навигационном тесте Gazebo провели по 20 заходов на вариант. Среднее число столкновений за заход снизилось с 1,35 до 0,45 при p = 0,038. Это единственная метрика безопасности, для которой авторы сообщили статистически значимое улучшение.
Худший зазор вырос с 0,16 до 0,52 м, а аварий стало меньше: одна против трёх на 20 заходов. Однако этих выборок недостаточно, чтобы уверенно отделить такие различия от случайного разброса. Цена обходов тоже заметна: длина пути в симуляции выросла с 54,5 до 68,7 м, пиковый рывок — в 2,6 раза.
Отдельные измерения производительности восприятия дали 9,96 Гц за 20 прогонов. Их следует отличать от проверки всей системы в замкнутом полётном контуре.
Честный вердикт: главный вопрос пока открыт
В городском тесте все встреченные классы уже находились в прогретом кэше. Онлайн-запросов к LLM во время этих заходов не было. Фактически планировщик получал заранее подготовленные параметры для человека, машины и грузовика. Для посадочных испытаний авторы не дают такого же прямого уточнения.
Отсюда главный вопрос: насколько результат отличается от обычной таблицы правил по классам? Сравнения с таким решением в работе нет. Поэтому исследование показывает пользу всей предложенной системы, но не доказывает необходимость языковой модели для ограниченного набора известных категорий.
Остаются и другие границы: только симуляция, три класса объектов, отдельно измеренные задержки на Jetson. Вход энкодера размером 224 пикселя ограничивает восприятие мелких и далёких объектов. Работа не подтверждает обобщение на новые категории или повышение безопасности в реальном полёте. Доступность открытого кода и данных также не подтверждена.
Наш вывод: ценность работы — в инженерной дисциплине вокруг маленькой модели. Узкий интерфейс, RAG, грамматика, валидация, кэш и память карты делают её пригодной для выдачи ограниченных параметров. Но вклад каждого элемента ещё предстоит отделить от остальных.
Что можно проверить самостоятельно
Начать можно со стендового эксперимента на Jetson или ноутбуке: запустить Qwen-0.5B через llama.cpp, задать классы «человек», «машина», «стена» и сравнить ответы с RAG и без него. Проверять следует отдельно устойчивость формата и обоснованность значений. Правильные скобки не делают ошибочное правило безопасным.
Для такого сравнения полезно добавить простую таблицу классов с фиксированными параметрами. Она покажет, какую задачу действительно решает модель и оправдывает ли эта задача дополнительные задержки и сложность.
Что бы вы доверили маленькой модели на борту, а что оставили бы классическому алгоритму?
Источник: Siwei Cai, Yuwei Wu, Vijay Kumar, Lifeng Zhou. Onboard Lightweight LLM Reasoning for Human-Aware Safe UAV Navigation.
Короткая новость по теме: публикация в канале PardAiLab.